RAG چیست؛ هوش مصنوعی چگونه با اطلاعات شرکت پاسخ میدهد؟
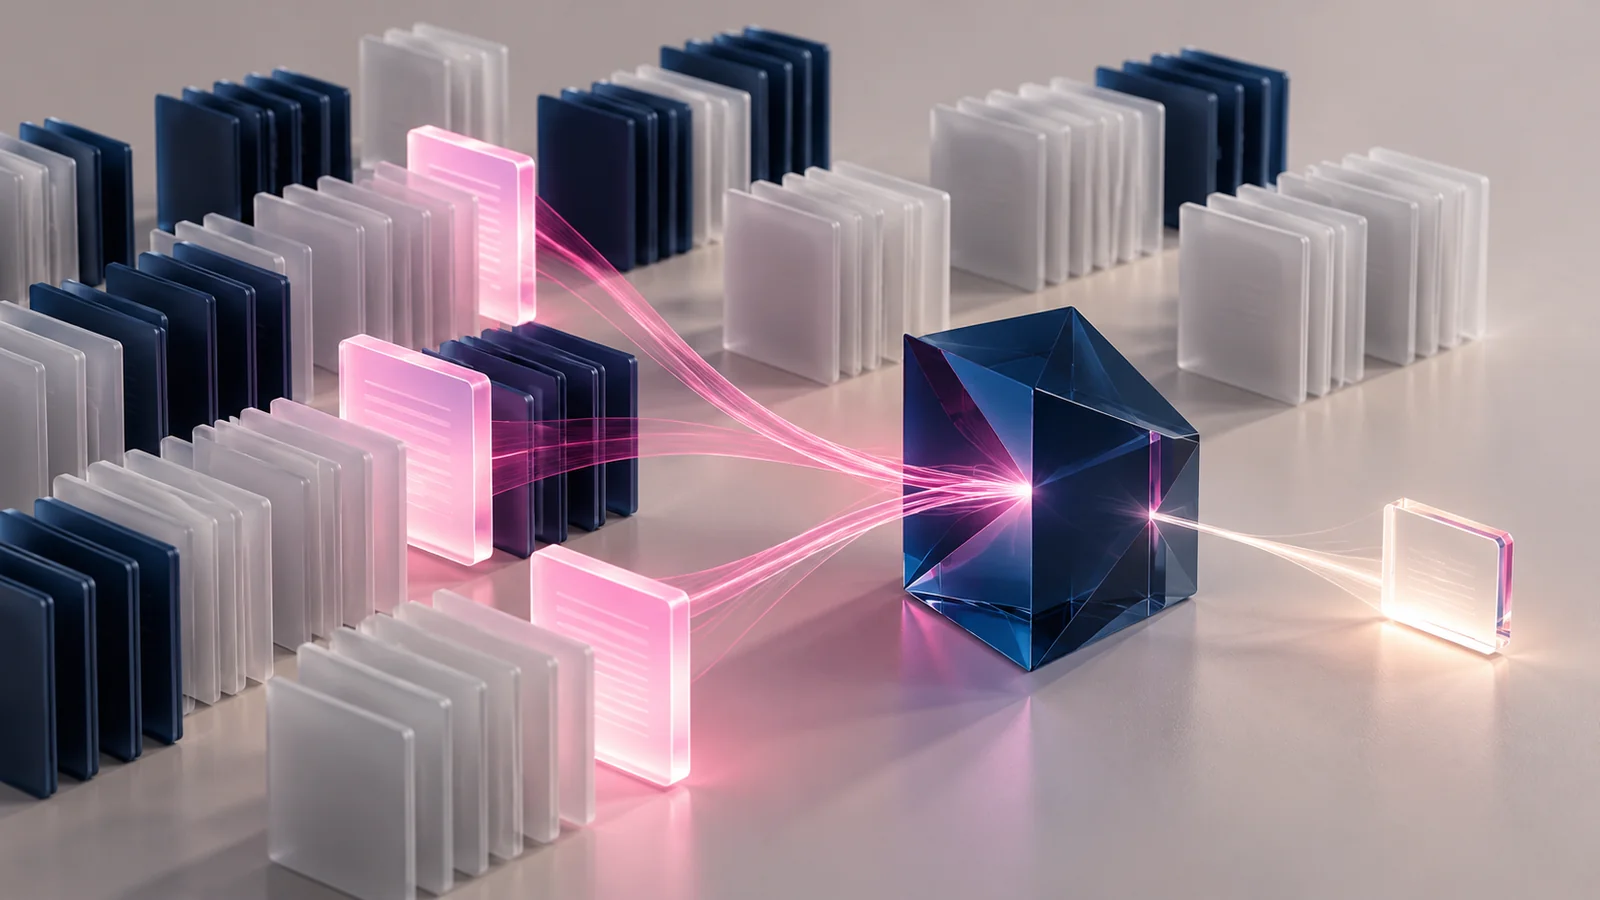
RAG مخفف Retrieval-Augmented Generation است؛ روشی که در آن، سامانه پیش از تولید پاسخ با هوش مصنوعی، اطلاعات مرتبط را از منابع مشخص پیدا میکند و در اختیار مدل زبانی قرار میدهد. به زبان ساده، مدل بهجای تکیهٔ صرف بر دانستههای قبلی خود، برای پاسخ به سؤال به اسناد و اطلاعاتی مراجعه میکند که برنامه برایش بازیابی کرده است.
فرض کنید کارشناس فروش دربارهٔ شرایط خدمات پس از فروش یک محصول سؤال دارد. یک مدل عمومی ممکن است سیاست واقعی شرکت را نداند. سامانهٔ مبتنی بر RAG میتواند بخش مرتبط از دستورالعمل معتبر شرکت را پیدا کند و به مدل بدهد تا پاسخ را بر همان اساس تنظیم کند. این مثال، سناریویی فرضی برای توضیح مفهوم است؛ کیفیت نتیجه به اطلاعات موجود و طراحی سامانه بستگی دارد.
RAG نام یک مدل خاص یا یک نرمافزار واحد نیست. این اصطلاح یک الگوی طراحی را توصیف میکند که میتوان آن را با مدلها و ابزارهای مختلف ساخت. پیش از انتخاب ابزار، باید روشن شود چه پرسشهایی قرار است پاسخ داده شوند، منبع معتبر هر پاسخ چیست و چه کسی اجازهٔ دیدن آن اطلاعات را دارد.
چرا یک مدل زبانی عمومی لزوماً اطلاعات کسبوکار شما را نمیداند؟
مدل زبانی از فرایند آموزش خود الگوها و دانستههایی کسب میکند، اما دسترسی خودکار و همیشگی به اسناد داخلی شرکت شما ندارد. حتی اگر دربارهٔ صنعت شما اطلاعات زیادی داشته باشد، لزوماً از آخرین نسخهٔ دستورالعمل، جزئیات یک قرارداد یا محدودیت خدمات شما آگاه نیست. پاسخ روان و قانعکننده نیز بهتنهایی نشان نمیدهد که پاسخ با سیاست فعلی کسبوکار مطابقت دارد.
میتوان اطلاعات لازم را مستقیماً در متن درخواست قرار داد، اما فرستادن همهٔ اسناد برای هر سؤال معمولاً راه مناسبی نیست. حجم ورودی، هزینهٔ پردازش و زمان پاسخ افزایش پیدا میکند و اطلاعات نامرتبط هم وارد گفتگو میشوند. نقش بازیابی این است که از میان منابع مجاز، بخشهای مناسب همان سؤال را انتخاب کند؛ نه اینکه صرفاً فایلهای بیشتری به مدل بدهد.
RAG چگونه کار میکند؛ از آمادهسازی منبع تا تولید پاسخ
ابتدا اطلاعات باید قابل جستوجو و قابل اعتماد شوند
در بسیاری از پیادهسازیها، اسناد جمعآوری و متن آنها استخراج میشود. سپس محتوا به بخشهای معنادار تقسیم و برای جستوجو آماده میشود. عنوان، تاریخ اعتبار، شناسهٔ سند و سطح دسترسی نیز میتوانند همراه هر بخش نگهداری شوند. این اطلاعات جانبی کمک میکنند سامانه میان یک دستورالعمل جاری و نسخهٔ منسوخ آن تفاوت بگذارد و پاسخ را به منبع قابل بررسی متصل کند.
تقسیم اسناد که با اصطلاح Chunking شناخته میشود، صرفاً بریدن متن در فاصلههای مساوی نیست. اگر شرط یک خدمت در یک بخش و استثنای آن در بخشی دورافتاده قرار بگیرد، بازیابی ناقص میتواند پاسخ گمراهکننده بسازد. ساختار واقعی سند، عنوانها، جدولها و ارجاعهای درون متن باید در آمادهسازی محتوا در نظر گرفته شوند. کیفیت همین مرحله میتواند روی نتیجهٔ نهایی اثر جدی بگذارد.
هنگام سؤال، سامانه اطلاعات مرتبط را بازیابی میکند
وقتی کاربر سؤال میپرسد، لایهٔ جستوجو بخشهایی از اطلاعات را انتخاب میکند که احتمالاً برای پاسخ مفیدند. جستوجو میتواند بر پایهٔ واژهها، شباهت معنایی یا ترکیبی از آنها باشد. برای مثال، سؤال کاربر ممکن است عبارت «پس دادن کالا» داشته باشد، اما سند رسمی از «شرایط مرجوعی» استفاده کرده باشد. روش بازیابی باید با نوع سؤالها و زبان اسناد ارزیابی شود.
در جستوجوی برداری، Embedding نمایش عددی محتواست که امکان مقایسهٔ شباهت را فراهم میکند. بااینحال، RAG الزاماً به یک Vector Database خاص وابسته نیست و هر سؤال نیز با جستوجوی معنایی بهتر پاسخ داده نمیشود. برای شناسهٔ دقیق محصول، کد خطا یا شمارهٔ بخشنامه، تطبیق واژه و فیلترهای مشخص ممکن است اهمیت زیادی داشته باشد. انتخاب فناوری باید از نیاز اطلاعاتی شروع شود.
مدل با سؤال و اطلاعات بازیابیشده پاسخ را تنظیم میکند
در مرحلهٔ تولید، سؤال کاربر و بخشهای انتخابشده همراه دستورهای برنامه به مدل داده میشوند. سامانه میتواند پاسخ را با نام سند یا پیوند به بخش مربوط نمایش دهد تا کاربر امکان بررسی داشته باشد. اگر اطلاعات کافی پیدا نشده باشد، رفتار مناسب میتواند بیان همین محدودیت یا ارجاع به کارشناس باشد. مجبورکردن مدل به پاسخدادن در همهٔ شرایط، معیار مناسبی برای کیفیت محصول نیست.
آیا استفاده از RAG به معنای آموزش دوبارهٔ مدل است؟
در الگوی معمول RAG، وزنهای مدل برای هر مجموعه سند تغییر نمیکنند؛ اطلاعات در زمان پاسخگویی در ورودی مدل قرار میگیرند. Fine-tuning فرایند دیگری است که با آموزش بیشتر، رفتار یا عملکرد مدل را برای یک کار مشخص سازگار میکند. برای نمونه، حفظ قالب خروجی یا یادگیری الگوهای خاص یک وظیفه میتواند مسئلهای متفاوت از دسترسی به جدیدترین دستورالعمل باشد.
این دو روش همیشه جایگزین یکدیگر نیستند و ممکن است در یک محصول ترکیب شوند. برای کسبوکاری که میخواهد پاسخها به اسناد متغیر متکی باشند، ابتدا باید مسئلهٔ دسترسی و بازیابی اطلاعات حل شود. استفاده از Fine-tuning بهتنهایی، مسیر مطمئنی برای نگهداری آخرین نسخهٔ هر سند یا اعمال مجوز دسترسی کاربران ایجاد نمیکند. تصمیم باید با آزمون کیفیت و برآورد هزینه همراه باشد.
RAG در چه نوع پروژههایی میتواند کاربرد داشته باشد؟
یکی از کاربردها، دستیار داخلی برای جستوجوی دانش سازمانی است: راهنمای فرایندها، مستندات محصول و پاسخ به پرسشهای تکراری کارکنان. ارزش آن زمانی بیشتر میشود که منابع معتبر وجود داشته باشند، اما پیداکردن بخش مناسب برای کاربر دشوار باشد. اگر اطلاعات فقط در ذهن افراد است یا سندها با یکدیگر تناقض دارند، پیش از توسعهٔ دستیار باید بخشی از مسئلهٔ مدیریت دانش حل شود.
در پشتیبانی مشتریان نیز میتوان پاسخهای پیشنهادی را از راهنمای محصولات و سیاستهای منتشرشده ساخت. برای شروع، نمایش پیشنهاد به کارشناس ممکن است از پاسخگویی خودکار کامل مناسبتر باشد. کارشناس میتواند خطاهای رایج، سؤالهای مبهم و کمبودهای مستندات را مشخص کند. پس از ارزیابی، تنها محدودههایی که کیفیت قابلقبولی دارند میتوانند برای خودکارسازی بیشتر بررسی شوند.
کاربرد دیگر، کمک به مرور مجموعهای از اسناد و یافتن بندهای مرتبط است. بااینحال، پیداکردن متن مرتبط با تضمین درستی تفسیر آن تفاوت دارد. در تصمیمهای حساس یا پرهزینه، خروجی باید قابل بررسی باشد و مسئولیت تصمیم نهایی روشن بماند. RAG میتواند زمان دسترسی به اطلاعات را تغییر دهد، اما جای اعتبارسنجی منبع و قضاوت تخصصی را بهطور خودکار نمیگیرد.
چه زمانی جستوجوی ساده یا API انتخاب مناسبتری است؟
اگر پاسخ باید یک عدد زنده مانند موجودی کالا، وضعیت سفارش یا اعتبار مشتری باشد، ممکن است مراجعهٔ کنترلشده به API سامانهٔ اصلی مناسبتر باشد. یک فایل قدیمی از موجودی نمیتواند جای منبع عملیاتی فعلی را بگیرد. در محصول واقعی میتوان توضیحات عمومی را از اسناد بازیابی کرد و وضعیت لحظهای را از API گرفت، به شرط آنکه منبع هر بخش و مجوز دسترسی مشخص باشد.
برای مجموعهای کوچک از پرسشهای ثابت نیز صفحهٔ راهنما یا جستوجوی معمولی ممکن است کفایت کند. اگر کاربر فقط میخواهد سند مشخصی را پیدا کند، تولید پاسخ تازه شاید ارزش کافی نسبت به هزینه ایجاد نکند. پرسش اصلی این است که ترکیب و توضیح اطلاعات چه کمکی به کاربر میکند و آیا میتوان همان نیاز را با راهکاری سادهتر و قابل نگهداری پاسخ داد.
چرا RAG خطا و پاسخ ساختگی را بهطور کامل حذف نمیکند؟
خطا میتواند پیش از رسیدن اطلاعات به مدل آغاز شود: متن از فایل درست استخراج نشده، نسخهٔ قدیمی انتخاب شده یا بخشی از پاسخ در سند دیگری باقی مانده است. مدل نیز ممکن است اطلاعات صحیح را نادرست تفسیر کند یا ادعایی فراتر از منبع بسازد. بنابراین باید کیفیت بازیابی و کیفیت پاسخ جداگانه بررسی شوند؛ تغییر مدل همیشه مشکل منبع یا جستوجو را حل نمیکند.
داشتن ارجاع در پاسخ مفید است، اما بهتنهایی کافی نیست. باید بررسی شود سند ارجاعشده واقعاً ادعای پاسخ را پشتیبانی میکند و کاربر مجاز به دیدن آن است. برای سؤال بدون پاسخ نیز سامانه باید بتواند کمبود اطلاعات را بیان کند. ارزیابیای که فقط سؤالهای آسان و دارای پاسخ روشن را شامل شود، تصویر دقیقی از رفتار محصول در استفادهٔ واقعی نمیدهد.
دادههای فارسی و اسناد نامنظم چه چالشهایی ایجاد میکنند؟
در یک پروژهٔ فارسی، باید کیفیت استخراج متن از فایلهای اسکنشده، جدولها و صفحههای دارای چیدمان پیچیده آزمایش شود. تفاوت نگارش واژهها، نیمفاصله، شکل حروف و ترکیب فارسی و English میتواند در آزمون جستوجو اهمیت پیدا کند. نباید از روی موفقیت یک نمونهٔ انگلیسی نتیجه گرفت که همان تنظیم برای مجموعهٔ واقعی اسناد فارسی مناسب خواهد بود.
برای نمونهٔ اولیه، انتخاب چند سند خوانا و مرتب کافی نیست. باید فایلهای مسئلهدار، سؤالهای کوتاه، نامهای مشابه و کدهای محصول نیز وارد آزمون شوند. اگر بخشی از محتوا قابل استخراج نیست، بهتر است این محدودیت ثبت و برطرف شود تا اینکه سامانه آن را بیصدا نادیده بگیرد. هزینهٔ پاکسازی و اصلاح منابع نیز باید جزئی از برآورد پروژه باشد.
کنترل دسترسی و بهروزرسانی اطلاعات باید از ابتدا طراحی شوند
اگر کارمند اجازهٔ مشاهدهٔ یک سند را ندارد، دستیار نیز نباید محتوای آن را برای او بازیابی و در پاسخ بازگو کند. محدودیت فقط در رابط کاربری کافی نیست؛ مجوز باید در مسیر دریافت اطلاعات اعمال شود. در سامانههای چندمشتری نیز جداسازی اطلاعات هر مشتری باید در بازیابی، تاریخچهٔ گفتگو و سایر اجزای مرتبط بررسی شود.
منابع بازیابیشده نیز میتوانند متن نادرست یا دستورهای فریبنده داشته باشند. اطلاعات یک فایل باید بهعنوان دادهٔ قابل بررسی پردازش شود، نه اینکه هر جملهٔ آن اختیار تغییر رفتار سامانه را پیدا کند. این مسئله با Prompt Injection ارتباط دارد. یک پیام راهنما به مدل میتواند بخشی از دفاع باشد، اما جای کنترل دسترسی و محدودیتهای اجرایی برنامه را نمیگیرد.
تغییر یا حذف سند نیز باید در دانش قابل جستوجوی سامانه منعکس شود. مشخص کنید چه کسی نسخهٔ معتبر را تأیید میکند، بهروزرسانی با چه تأخیری انجام میشود و اگر مجوز یک کاربر لغو شد، اثر آن در کدام بخشها باید اعمال شود. بدون این مسئولیتها، دستیار ممکن است همچنان بر پایهٔ اطلاعاتی پاسخ دهد که دیگر معتبر یا مجاز نیستند.
هزینهٔ واقعی پروژهٔ RAG فقط هزینهٔ مدل زبانی نیست
بخشی از هزینه به آمادهسازی منابع، استخراج متن، ایجاد و بهروزرسانی ایندکس و طراحی اتصالها مربوط است. بخش دیگری در زمان استفاده ظاهر میشود: جستوجو، رتبهبندی، ارسال متن به مدل و تولید پاسخ. در پروژهای با اسناد متغیر یا فایلهای دشوار، نگهداری مسیر ورود اطلاعات میتواند به اندازهٔ ظاهر چت اهمیت داشته باشد.
پشتیبانی، پایش خطاها و ارزیابی نسخههای جدید نیز هزینهٔ مداوم دارند. اگر مدل، روش جستوجو یا محتوای منابع تغییر کند، باید بررسی شود کیفیت پاسخها افت نکرده باشد. استفاده از خدمات مدیریتشده ممکن است بخشی از کار زیرساخت را کاهش دهد، اما نیاز به شناخت داده، کنترل دسترسی و آزمون محصول باقی میماند. برآورد باید با حجم واقعی اسناد و الگوی استفاده انجام شود.
یک سناریوی فرضی؛ شروع محدود برای دستیار پشتیبانی محصولات
فرض کنید شرکتی چند گروه محصول و مجموعهای از راهنماها و شرایط پشتیبانی دارد. کارشناسان برای پاسخ به سؤالهای مشتریان بین فایلهای مختلف جستوجو میکنند. شروع قابل بررسی این است که یک گروه محصول با اسناد تأییدشده انتخاب شود و دستیار فقط پاسخ پیشنهادی همراه منبع به کارشناس بدهد. در این مرحله دسترسی به پروندههای مشتریان یا اجرای عملیات ضروری نیست.
سپس میتوان سؤالهای واقعی را با نظر کارشناسان جمعآوری کرد: موارد دارای پاسخ روشن، موارد نیازمند چند سند، پرسشهای بدون پاسخ و اطلاعات منسوخ. اگر خطاها بیشتر ناشی از ناقصبودن منابع باشند، اصلاح محتوا باید در اولویت قرار بگیرد. اگر منابع مناسباند اما درست پیدا نمیشوند، باید روش بازیابی بررسی شود. این تفکیک جلوی هزینهکردن برای تغییرات نامرتبط را میگیرد.
گسترش سامانه زمانی قابل دفاعتر است که معلوم شود کارشناس سریعتر به پاسخ قابلقبول میرسد و بار بررسی خطاها، منفعت ایجادشده را از بین نمیبرد. این نتیجه باید اندازهگیری شود و تضمین اولیه نیست. همچنین موفقیت در راهنمای یک محصول، بهتنهایی مجوز اتصال دستیار به همهٔ اسناد سازمان یا پاسخگویی خودکار در همهٔ حوزهها محسوب نمیشود.
برای ارزیابی نمونهٔ اولیهٔ RAG چه معیارهایی مناسباند؟
| معیار | چه چیزی بررسی شود؟ |
|---|---|
| بازیابی اطلاعات | آیا بخش معتبر و مرتبط پیدا میشود؟ |
| درستی پاسخ | آیا ادعاها از اطلاعات بازیابیشده پشتیبانی میشوند؟ |
| اعتبار منبع | آیا نسخه و تاریخ سند درست است و ارجاع قابل بررسی است؟ |
| کمبود اطلاعات | آیا سامانه هنگام نبود پاسخ، محدودیت را بیان میکند؟ |
| دسترسی | آیا کاربر فقط اطلاعات مجاز خود را دریافت میکند؟ |
| زمان و هزینه | آیا منفعت کاربر با هزینهٔ هر استفاده و پشتیبانی تناسب دارد؟ |
معیار پذیرش باید پیش از اجرای گسترده مشخص شود. برای مثال، پاسخ پیشنهادی به کارشناس و پاسخ مستقیم به مشتری ممکن است سطح تحمل خطای متفاوتی داشته باشند. سؤالهای آزمون نیز بهتر است از نمونههای نمایش محصول جدا باشند تا تیم فقط برای چند نمایش موفق بهینهسازی نکند. ثبت خطاها باید به تصمیم اصلاحی مشخص دربارهٔ منبع، بازیابی یا تولید پاسخ منجر شود.
پیش از شروع پروژه، کدام تصمیمها باید روشن شوند؟
- مخاطب دستیار کیست و چه سؤالهایی در محدودهٔ آن قرار میگیرند؟
- منبع معتبر هر حوزه چیست و مالک بهروزرسانی آن چه کسی است؟
- کدام اطلاعات محرمانهاند و مجوز دسترسی چگونه اعمال میشود؟
- آیا پاسخ باید بر اساس سند باشد یا دادهٔ زندهٔ یک سامانه؟
- هنگام ابهام یا نبود منبع، مسیر ارجاع به انسان چیست؟
- کیفیت، هزینه و زمان پاسخ با چه نمونهها و معیارهایی سنجیده میشوند؟
RAG زمانی ارزشمند است که بازیابی دانش مسئلهٔ واقعی پروژه باشد
RAG روشی برای پیوند دادن تولید پاسخ با منابع اطلاعاتی مشخص است. ارزش آن فقط در ساخت یک پنجرهٔ گفتگو نیست؛ در پیداکردن اطلاعات مرتبط، حفظ اعتبار و مجوز منابع و ارائهٔ پاسخ قابل بررسی شکل میگیرد. اگر اسناد قابل اتکا و نیاز روشن وجود داشته باشند، شروع محدود و ارزیابیشده میتواند راه مناسبی برای سنجیدن کاربرد آن باشد.
برای بررسی چنین پروژهای، بهتر است ابتدا چند سؤال واقعی، نمونهٔ منابع و محدودیتهای دسترسی مشخص شوند. این ورودیها کمک میکنند بین جستوجوی معمولی، RAG و اتصال مستقیم به API انتخاب سنجیدهتری انجام شود. برای آشنایی با نقش عاملها، مقالهٔ AI Agent چیست و چه کاربردی دارد؟ را بخوانید؛ برای بررسی نیاز اختصاصی نیز میتوانید از مسیر شروع پروژه با پارسپلن در ارتباط باشید.