DevOps چیست؛ شغل یا فناوری؟
DevOps دقیقاً چیست و DevOps Engineer کیست؟ این اصطلاح هم به یک رویکرد مهندسی اشاره میکند و هم در بازار کار به عنوان شغل استفاده میشود؛ اما هیچکدام به معنای یک نرمافزار خاص نیست. در این مقاله تفاوت فرهنگ DevOps، نقش مهندس DevOps و ابزارهای آن را با مثالهای واقعی از توسعه و استقرار نرمافزار بررسی میکنیم.

DevOps چیست و چرا در توسعه نرمافزار اهمیت دارد؟
واژه DevOps از ترکیب Development به معنای توسعه نرمافزار و Operations به معنای عملیات فناوری اطلاعات ساخته شده است. با این حال، تعریف DevOps فراتر از کنار هم گذاشتن دو تیم یا چند ابزار نرمافزاری است. DevOps یک رویکرد فرهنگی و مهندسی برای سازماندهی همکاری، خودکارسازی و مسئولیتپذیری در سراسر چرخه عمر نرمافزار است؛ چرخهای که از برنامهریزی و تولید کد آغاز میشود و تا استقرار، پایش، نگهداری و دریافت بازخورد از محیط عملیاتی ادامه پیدا میکند.
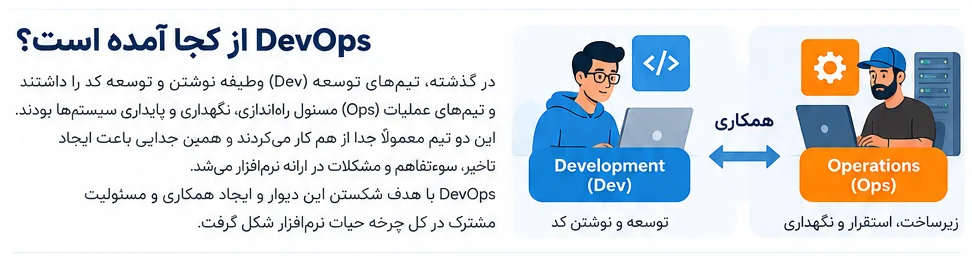
در سازمانهایی که از الگوی سنتی استفاده میکنند، تیم توسعه معمولاً مسئول تولید نسخه جدید است و پس از تکمیل کدنویسی، فایلها یا بسته نرمافزاری را به تیم عملیات تحویل میدهد. تیم عملیات باید این خروجی را روی سرورهای واقعی نصب و اجرا کند. اختلاف نسخه کتابخانهها، تنظیمات شبکه، مجوزها، متغیرهای محیطی یا محدودیت منابع ممکن است باعث شود برنامهای که در سیستم توسعهدهنده درست کار میکرد، در محیط عملیاتی دچار خطا شود.
DevOps تلاش میکند این فاصله سازمانی و فنی را کاهش دهد. در این شیوه، اعضای تیم از مراحل ابتدایی توسعه درباره نحوه اجرا، قابلیت تست، امنیت، نیازهای منابع و بازیابی پس از خطا تصمیم میگیرند. بنابراین هدف صرفاً انتشار سریعتر نسخهها نیست؛ بلکه تحویل تغییرات به شکلی قابلاعتماد، قابلتکرار، قابلاندازهگیری و متناسب با سطح ریسک محصول است.
آیا DevOps یک شغل است، یک فناوری یا یک فرهنگ کاری؟
پاسخ دقیق این است که DevOps در معنای اصلی یک فرهنگ و مجموعهای از شیوههای مهندسی است؛ اما در بازار کار عنوان شغلی DevOps Engineer نیز وجود دارد. خود DevOps مانند یک پایگاه داده، سیستمعامل یا برنامه قابل نصب نیست. برای مثال Docker یک فناوری کانتینرسازی و Kubernetes سامانهای برای هماهنگسازی بارهای کاری کانتینری است؛ در حالی که DevOps چارچوبی برای بهکارگیری درست ابزارها و فرآیندها در جهت بهبود تحویل نرمافزار به شمار میرود.
شرکتی را تصور کنید که Kubernetes نصب کرده ولی هنوز برای انتشار هر نسخه نیاز دارد چند نفر با پیامهای دستی هماهنگ شوند، فایلهای تنظیمات روی سرورها تغییر داده شوند و آزمایش نرمافزار پس از انتشار انجام شود. استفاده از Kubernetes بهتنهایی این سازمان را DevOpsمحور نمیکند. در مقابل، یک تیم کوچک با Git، تست خودکار، ثبت دقیق نسخهها و اسکریپتهای استقرار میتواند بخش بزرگی از اصول DevOps را پیاده کند، بدون اینکه به زیرساخت پیچیده نیاز داشته باشد.
بنابراین باید میان سه مفهوم تفاوت قائل شد: DevOps بهعنوان رویکرد همکاری و تحویل نرمافزار؛ DevOps Engineer بهعنوان متخصصی که زیرساخت و فرآیندهای مرتبط را طراحی میکند؛ و DevOps Tools بهعنوان ابزارهایی مانند GitLab CI/CD، Jenkins، Docker، Ansible و Terraform که بخشی از این فرآیندها را خودکار میکنند. هیچیک از این سه مفهوم جانشین کامل دو مورد دیگر نیست.
DevOps Engineer کیست و در یک شرکت چه کارهایی انجام میدهد؟
مهندس DevOps متخصصی است که دانش توسعه نرمافزار را با مهارتهای مدیریت سیستم، شبکه، زیرساخت و خودکارسازی ترکیب میکند. کار اصلی او الزاماً استقرار دستی برنامه یا نگهداری روزمره سرورها نیست؛ بلکه ساخت بستری است که تیمهای توسعه بتوانند کد را با کیفیت مناسب، خطای کمتر و سرعت قابلپیشبینی به محیطهای مختلف منتقل کنند. شرح وظایف این نقش با توجه به اندازه شرکت و معماری محصول متفاوت است.
در یک مجموعه کوچک، مهندس DevOps ممکن است سرورهای لینوکسی، Reverse Proxy، گواهیهای TLS، بکاپ و Pipeline استقرار را مدیریت کند. در یک شرکت بزرگتر، فعالیت او میتواند بر مدیریت کلاسترهای Kubernetes، طراحی پلتفرم داخلی توسعهدهندگان، استانداردسازی زیرساخت ابری، تنظیم سیاستهای امنیتی، مانیتورینگ و مدیریت هزینه منابع متمرکز باشد. تفاوت محیطها بسیار مهم است؛ عنوان شغلی مشابه الزاماً به معنای شرح وظایف یکسان نیست.
برای مثال، فرض کنید یک فروشگاه اینترنتی سه سرویس مستقل برای کاربران، سفارشها و پرداخت دارد. اگر هر تغییر نیازمند اتصال دستی به سرور، توقف سرویس، انتقال فایل و اجرای چند فرمان باشد، احتمال خطا بالا میرود. مهندس DevOps میتواند فرآیندی طراحی کند که کد تازه پس از بررسی کیفیت و تست، به یک Artifact نسخهبندیشده تبدیل شود، در محیط آزمایشی اجرا شود و سپس با کنترلهای مشخص به محیط عملیاتی برسد. همزمان باید امکان مشاهده وضعیت سرویس، تشخیص خرابی و بازگشت به نسخه سالم وجود داشته باشد.
چرخه DevOps از نوشتن کد تا اجرای پایدار نرمافزار چگونه شکل میگیرد؟
چرخه DevOps معمولاً با برنامهریزی نیازمندیها و طراحی تغییرات شروع میشود. تیم در این مرحله علاوه بر ویژگیهای محصول، اثر تغییر بر پایگاه داده، سازگاری APIها، محدودیت منابع، مخاطرات امنیتی و معیارهای موفقیت را بررسی میکند. چنین تصمیمهایی اگر به انتهای پروژه موکول شوند، ممکن است انتشار را دشوار یا پرخطر کنند.
سپس توسعهدهندگان تغییرات را در مخزن کد ثبت میکنند. سرویس یکپارچهسازی مداوم با هر تغییر تعیینشده میتواند Build، تست واحد، تحلیل ایستای کد و بررسی وابستگیها را انجام دهد. پس از موفقیت این کنترلها، خروجی مشخصی تولید میشود که ممکن است فایل باینری، بسته نرمافزاری یا Container Image باشد. نگهداری Artifact با شناسه نسخه یا شناسه Commit اهمیت دارد، زیرا همان خروجی آزمایششده باید برای مراحل بعدی استفاده شود و بازسازی ناخواسته آن ممکن است نتایج متفاوتی ایجاد کند.
در مرحله تحویل و استقرار، نرمافزار به محیط آزمایشی و سپس مطابق سیاست سازمان به محیط عملیاتی منتقل میشود. استقرار میتواند دستی، تأییدشونده یا خودکار باشد. تکنیکهای Rolling Update، Blue-Green و Canary Release کمک میکنند تغییرات بهصورت کنترلشده منتشر شوند؛ اما انتخاب روش مناسب به معماری محصول، نوع ترافیک، سازگاری پایگاه داده و امکان بازگشت به نسخه قبلی بستگی دارد.
کار پس از استقرار پایان پیدا نمیکند. تیم باید نرخ خطا، زمان پاسخگویی، مصرف منابع، سلامت پایگاه داده و شاخصهای مهم کسبوکار را بررسی کند. اگر پس از انتشار مشکلی رخ دهد، باید بهجای اتکا به حدس، بتوان با دادههای واقعی ریشه مشکل را پیدا کرد. بازخورد این مرحله به برنامهریزی و توسعه بعدی منتقل میشود و چرخه بهبود مستمر شکل میگیرد.
CI/CD چیست و چرا مهمترین بخش خودکارسازی در DevOps است؟
CI مخفف Continuous Integration یا یکپارچهسازی مداوم است. در این شیوه، تغییرات کوچک و مکرر کد وارد یک مخزن مشترک میشوند و یک سامانه خودکار عملیات ساخت و آزمون را اجرا میکند. هدف اصلی، شناسایی سریع ناسازگاریها و جلوگیری از جمع شدن تغییرات بزرگ و پرریسک است. وجود CI بهمعنای تضمین نبود خطا نیست؛ کیفیت آن به پوشش تست، سرعت بازخورد و نحوه مدیریت شکستها بستگی دارد.
CD دو معنای نزدیک اما متفاوت دارد. Continuous Delivery یعنی نرمافزار پس از عبور از کنترلهای تعریفشده آماده انتشار باشد، حتی اگر انتشار نهایی به تأیید انسانی نیاز داشته باشد. Continuous Deployment یک گام جلوتر است و هر تغییر موفق را بدون تأیید دستی در هر نوبت، به محیط عملیاتی منتقل میکند. رویکرد دوم به تست قابلاعتماد، کنترل دسترسی، قابلیت مشاهده وضعیت سرویس و روش روشن برای توقف یا بازیابی نیاز دارد.
یک Pipeline حرفهای نباید تنها به اجرای چند دستور Build محدود شود. مدیریت Secretها، جداسازی محیطها، ثبت نتیجه آزمونها، اسکن آسیبپذیری، امضای Artifact در صورت نیاز و مجوزهای محدود برای استقرار، همگی بخشی از طراحی امن فرآیند هستند. همچنین خوب است شکست یک مرحله، مراحل وابسته بعدی را متوقف کند تا نسخه ناقص به محیط عملیاتی منتقل نشود.
ابزارهای DevOps چه هستند و هرکدام چه مسئلهای را حل میکنند؟
Git برای ثبت تاریخچه و مدیریت نسخههای کد استفاده میشود و بسترهایی مانند GitHub و GitLab امکانات بازبینی کد و یکپارچهسازی با فرآیندهای خودکار را فراهم میکنند. Jenkins، GitLab CI/CD و GitHub Actions برای اجرای Pipeline به کار میروند. این ابزارها وظیفه مشابهی را با مدلهای پیکربندی و اجرای متفاوت انجام میدهند و انتخاب میان آنها باید بر اساس نیاز تیم، هزینه نگهداری و یکپارچگی با سامانههای موجود باشد.
Docker بستهبندی برنامه و وابستگیهای اجرایی آن را در قالب Image امکانپذیر میکند و به کاهش اختلاف محیطها کمک میکند. با این حال، کانتینرها همچنان از هسته سیستمعامل میزبان استفاده میکنند و تنظیمات شبکه، ذخیرهسازی و منابع محیط میتوانند نتیجه اجرا را تغییر دهند. Kubernetes در مقیاس بزرگتر برای زمانبندی و مدیریت بارهای کاری کانتینری، سرویسیابی، مدیریت Replicaها و فرآیندهای بهروزرسانی به کار میرود؛ اما برای همه پروژهها ضروری نیست.
Terraform در حوزه Infrastructure as Code به تعریف و مدیریت منابع زیرساختی کمک میکند. Ansible معمولاً برای پیکربندی سیستمها، نصب بستهها و خودکارسازی فعالیتهای عملیاتی کاربرد دارد. Prometheus برای گردآوری و پرسوجوی متریکها و Grafana برای نمایش دادهها و داشبوردها استفاده میشوند. این ابزارها مکمل یکدیگرند، اما استفاده از همه آنها همزمان نه نشانه بلوغ فنی است و نه الزام یک معماری سالم.
Infrastructure as Code چگونه مدیریت زیرساخت را قابلتکرار میکند؟
در مدیریت سنتی، تنظیم یک سرور ممکن است شامل دهها تغییر دستی باشد؛ از نصب سرویس و باز کردن پورت تا تنظیم کاربران و دسترسیها. وقتی این کارها مستند و نسخهبندی نشده باشند، بازتولید دقیق محیط دشوار میشود. Infrastructure as Code یا IaC به تیم امکان میدهد بخش مهمی از وضعیت مطلوب زیرساخت را در فایلهای قابل بازبینی تعریف کند و تغییرات را از مسیر مشخص اجرا کند.
برای مثال، تعریف ماشین مجازی، شبکه خصوصی، قواعد فایروال و منابع ذخیرهسازی در پیکربندی Terraform باعث میشود افراد بتوانند پیشنهاد تغییرات را پیش از اعمال مشاهده کنند. در کنار آن، Ansible میتواند وظایفی مانند نصب بستهها و تنظیم سرویسها را انجام دهد. نگهداری این فایلها در Git به شفافیت تغییرات و بازبینی فنی کمک میکند.
البته IaC بدون مدیریت درست State، امنیت اطلاعات حساس و کنترل مجوزها میتواند مخاطرهآمیز باشد. فایلهای وضعیت ممکن است حاوی دادههای حساس باشند و اشتباه در یک تغییر، تعداد زیادی منبع را تحت تأثیر قرار دهد. بنابراین طراحی فرآیند بررسی تغییرات، نگهداری امن State و محدودسازی دسترسی به اجرای تغییرات، به اندازه انتخاب ابزار اهمیت دارد.
آیا مهندس DevOps همان مدیر سرور، SRE یا Platform Engineer است؟
مدیر سیستم یا System Administrator معمولاً بر نصب، پیکربندی، عیبیابی و نگهداری سیستمعاملها و سرویسهای زیرساختی تمرکز دارد. مهندس DevOps علاوه بر این زمینهها، جریان ساخت و تحویل نرمافزار و ارتباط آن با عملیات را خودکار و استاندارد میکند. این دو نقش میتوانند مهارتهای مشترک زیادی داشته باشند، اما هدف سازمانی آنها الزاماً یکسان نیست.
Site Reliability Engineering یا SRE رویکردی برای مهندسی قابلیت اطمینان سرویسهاست. تیمهای SRE معمولاً از شاخصهای SLI، اهداف SLO و مفهومی به نام Error Budget استفاده میکنند تا درباره تعادل میان تغییرات و پایداری تصمیم بگیرند. Platform Engineering نیز بیشتر بر ایجاد بستر داخلی و تجربه سلفسرویس برای توسعهدهندگان متمرکز است تا تیمها مجبور نباشند برای فعالیتهای تکراری زیرساختی از ابتدا راهکار بسازند.
در سازمانهای کوچک ممکن است یک نفر بخشی از مسئولیتهای هر سه حوزه را انجام دهد. در شرکتهای بزرگتر، تیمها بهصورت تخصصی تفکیک میشوند. به همین دلیل، برای ارزیابی یک موقعیت شغلی DevOps، بررسی فناوریها، مسئولیت نگهداری Production، نوع On-call و اختیار تغییر زیرساخت از خود عنوان شغلی مهمتر است.
امنیت و DevSecOps چه جایگاهی در فرآیند DevOps دارند؟
خودکارسازی انتشار اگر بدون کنترلهای امنیتی انجام شود، تنها سرعت انتقال آسیبپذیری به محیط واقعی را افزایش میدهد. DevSecOps بر ادغام ملاحظات امنیتی در طول توسعه، ساخت، انتشار و عملیات تأکید دارد. برای نمونه، بررسی وابستگیهای آسیبپذیر، اسکن Container Image، تحلیل ایستای کد و بررسی پیکربندی زیرساخت را میتوان به بخشهایی از Pipeline اضافه کرد.
نگهداری گذرواژهها و Tokenها در مخزن کد یکی از خطاهای رایج است. برای کاهش این خطر، اطلاعات محرمانه باید با سامانه مناسب Secrets Management ذخیره شوند و حسابهای سرویس مطابق اصل کمترین سطح دسترسی مجوز بگیرند. همچنین استفاده از هویتهای کوتاهعمر و ثبت رویدادهای مهم دسترسی، در صورت پشتیبانی زیرساخت، به کاهش ریسک کمک میکند.
امنیت زنجیره تأمین نرمافزار نیز اهمیت دارد؛ زیرا خروجی نهایی تنها حاصل کد نوشتهشده توسط تیم نیست و به کتابخانهها، Imageهای پایه و سامانه Build وابسته است. حفاظت از این اجزا و اطمینان از منشأ بستهها باید متناسب با حساسیت محصول طراحی شود. DevSecOps به معنای حذف تیم امنیت نیست، بلکه هدف آن همکاری نزدیکتر متخصصان توسعه، عملیات و امنیت است.
مانیتورینگ و Observability چگونه از اختلال در Production جلوگیری میکنند؟
موفقیت Pipeline بهتنهایی اثبات نمیکند نسخه جدید در شرایط واقعی درست کار میکند. در زمان افزایش ترافیک، تغییر رفتار وابستگیها یا فشار بر پایگاه داده ممکن است مشکلاتی ظاهر شوند که در محیط تست قابل مشاهده نبودند. مشاهدهپذیری یا Observability به توانایی درک وضعیت داخلی سیستم از طریق دادههای آن اشاره دارد و معمولاً بر Metrics، Logs و Traces تکیه میکند.
Metrics مانند نرخ درخواست، درصد خطا، زمان پاسخگویی و مصرف CPU برای شناخت روند و تعریف هشدار مفیدند. Logs رخدادهای برنامه و زیرساخت را ثبت میکنند و بهتر است ساختارمند، قابل جستوجو و فاقد اطلاعات محرمانه باشند. Traces نیز مسیر یک درخواست را میان سرویسهای مختلف دنبال میکنند و در معماری Microservices برای یافتن گلوگاههای تأخیر اهمیت دارند.
هشدارها باید با نشانههای معنادار خرابی سرویس و تجربه کاربران پیوند داشته باشند. ایجاد دهها هشدار کماهمیت میتواند خستگی عملیاتی ایجاد کند و باعث شود مشکل جدی دیر دیده شود. در کنار ابزارهای پایش، تیم به فرآیند پاسخگویی به رخداد، مسئول مشخص، Runbook و بازبینی پس از حادثه نیاز دارد تا از تکرار مشکلات جلوگیری کند.
آیا DevOps هزینه زیرساخت را کاهش میدهد و سرعت توسعه را بالا میبرد؟
DevOps میتواند زمان انتظار بین تیمها، تکرار کارهای دستی و خطاهای ناشی از انتشار را کاهش دهد. وقتی ساخت و استقرار قابلتکرار باشند، توسعهدهندگان بازخورد سریعتری میگیرند و تیم عملیات زمان بیشتری برای حل مسائل اساسی خواهد داشت. با این حال، کاهش هزینه یا افزایش سرعت نتیجه تضمینشده نصب ابزارهای جدید نیست.
برای یک برنامه کوچک، راهاندازی Kubernetes ممکن است نسبت به استقرار ساده روی ماشین مجازی پیچیدگی و هزینه نگهداری بیشتری ایجاد کند. انتخاب زیرساخت باید با تعداد سرویسها، نیازهای مقیاسپذیری، توان تیم، الزامات امنیت و بودجه تناسب داشته باشد. معیار حرفهای موفقیت، انتخاب کمپیچیدگیترین راهکار قابلاعتماد برای مسئله واقعی است، نه استفاده از فهرست بلندتری از فناوریها.
برای ارزیابی اثر بهبودها میتوان زمان انتقال تغییر تا Production، نرخ شکست تغییرات، دفعات انتشار، زمان بازیابی سرویس و میزان کار دستی تکراری را اندازهگیری کرد. این شاخصها باید در کنار کیفیت محصول و تجربه کاربران تحلیل شوند؛ زیرا افزایش تعداد انتشارها بدون حفظ پایداری بهتنهایی موفقیت محسوب نمیشود.
برای ورود به شغل DevOps از کجا باید شروع کرد؟
یک مسیر یادگیری مؤثر با اصول پایه آغاز میشود. تسلط بر Linux، فایلسیستم، پردازهها، سرویسهای systemd، مجوزها و عیبیابی خط فرمان ضروری است. سپس باید مفاهیم شبکه مانند TCP/IP، DNS، HTTP، TLS، Reverse Proxy، مسیریابی و فایروال را در عمل شناخت. بسیاری از مشکلات ظاهراً مربوط به برنامه، در واقع از اتصال، نامگذاری، گواهی یا تنظیمات سیستم ناشی میشوند.
گام بعدی یادگیری Git و یک زبان اسکریپتنویسی مانند Bash یا Python است. سپس میتوان با یک پروژه واقعی، فرآیند تست و ساخت خودکار را در GitLab CI/CD یا GitHub Actions پیاده کرد. پس از آن آشنایی با Docker، مدیریت نسخه Artifact، استقرار روی سرور و ایجاد مانیتورینگ پایه، تصویر واقعیتری از تحویل نرمافزار به دست میدهد.
در مرحله پیشرفتهتر میتوان Infrastructure as Code، Kubernetes، سرویسهای ابری، مدیریت Secretها و اصول امنیت را آموخت. انجام پروژه عملی، مانند ساخت سامانهای که تغییر کد را تست کند، Image بسازد، در محیط آزمایشی مستقر کند و وضعیت آن را پایش کند، بسیار ارزشمندتر از حفظ کردن دستورهای پراکنده است. ورود به این تخصص از مسیر برنامهنویسی Backend، مدیریت سیستم، شبکه یا زیرساخت ابری امکانپذیر است.
چرا استخدام یک DevOps Engineer بهتنهایی برای اجرای DevOps کافی نیست؟
سازمانی که تمام مسئولیت کیفیت و پایداری را به یک متخصص DevOps واگذار کند، ممکن است همان دیوار قدیمی میان توسعه و عملیات را با نام جدید بازسازی کند. اگر توسعهدهندگان از رفتار نرمافزار پس از انتشار اطلاعی نداشته باشند، تستها جدی گرفته نشوند و تغییرات بدون بازبینی ثبت شوند، حتی بهترین سامانههای خودکارسازی نیز نمیتوانند تمام مشکلات را جبران کنند.
برای اجرای مؤثر این رویکرد باید نقشها و مسئولیتها روشن باشند، مسیر انتشار مستند شود و اطلاعات حاصل از محیط عملیاتی به تیم سازنده محصول بازگردد. در بعضی سازمانها یک تیم پلتفرم ابزارهای مشترک را توسعه میدهد و در برخی دیگر متخصصان زیرساخت در کنار تیمهای محصول کار میکنند. انتخاب ساختار باید بر مبنای اندازه تیم و پیچیدگی محصول باشد، نه صرفاً تقلید از الگوی شرکتهای بزرگ.
جمعبندی؛ DevOps دقیقاً چیست و DevOps Engineer چه کسی است؟
DevOps در اصل یک فناوری منفرد و یک نرمافزار قابل نصب نیست؛ بلکه فرهنگ همکاری و مجموعهای از شیوههای فنی برای اتصال توسعه نرمافزار به عملیات، خودکارسازی تحویل و بهبود مستمر قابلیت اطمینان است. ابزارهایی مانند Docker، Kubernetes، GitLab CI/CD و Terraform میتوانند اجرای این اصول را تسهیل کنند، اما استفاده از آنها بهتنهایی معادل DevOps نیست.
در عین حال، DevOps Engineer یک شغل تخصصی و واقعی است. این فرد با ترکیب دانش نرمافزار، Linux، شبکه، امنیت و زیرساخت، مسیر ساخت، آزمایش، انتشار و پایش برنامه را طراحی و بهبود میدهد. شاخص نهایی موفقیت نه نام تیم و نه تعداد ابزارهای نصبشده، بلکه توانایی سازمان در تحویل تغییرات امن، قابلپیشبینی، قابلتکرار و پایدار است.